Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASAВ первой части мы разобрали, как устроен Uncloud и из каких компонентов складывается его кластерная модель. А теперь возьмем эту архитектуру и посмотрим, как она ведёт себя в реальной эксплуатации. Мы уже умеем объединять несколько Docker-хостов, запускать на них сервисы, связывать контейнеры через общую сеть, находить их по именам и публиковать приложение, насколько этого достаточно для работы в продуктиве.В этом материале рассмотрим, как Uncloud обновляет сервисы и проверяет новые контейнеры, доставляет Docker-образы, управляет размещением workload, что происходит со stateful-приложениями, как передаются чувствительные данные и как мы можем отслеживать состояние кластера. Также разберём ограничения этой модели — в большей степени они определяют, для каких задач Uncloud действительно подходит, а где уже стоит смотреть в сторону иных решений. Читать далее
Время на прочтение11 мин
Охват и читатели6.4K
Обзор
В первой части мы разобрали, как устроен Uncloud и из каких компонентов складывается его кластерная модель. А теперь возьмем эту архитектуру и посмотрим, как она ведёт себя в реальной эксплуатации.
Мы уже умеем объединять несколько Docker-хостов, запускать на них сервисы, связывать контейнеры через общую сеть, находить их по именам и публиковать приложение, насколько этого достаточно для работы в продуктиве.
В этом материале рассмотрим, как Uncloud обновляет сервисы и проверяет новые контейнеры, доставляет Docker-образы, управляет размещением workload, что происходит со stateful-приложениями, как передаются чувствительные данные и как мы можем отслеживать состояние кластера. Также разберём ограничения этой модели — в большей степени они определяют, для каких задач Uncloud действительно подходит, а где уже стоит смотреть в сторону иных решений.
 Проверка работоспособности и healthcheck
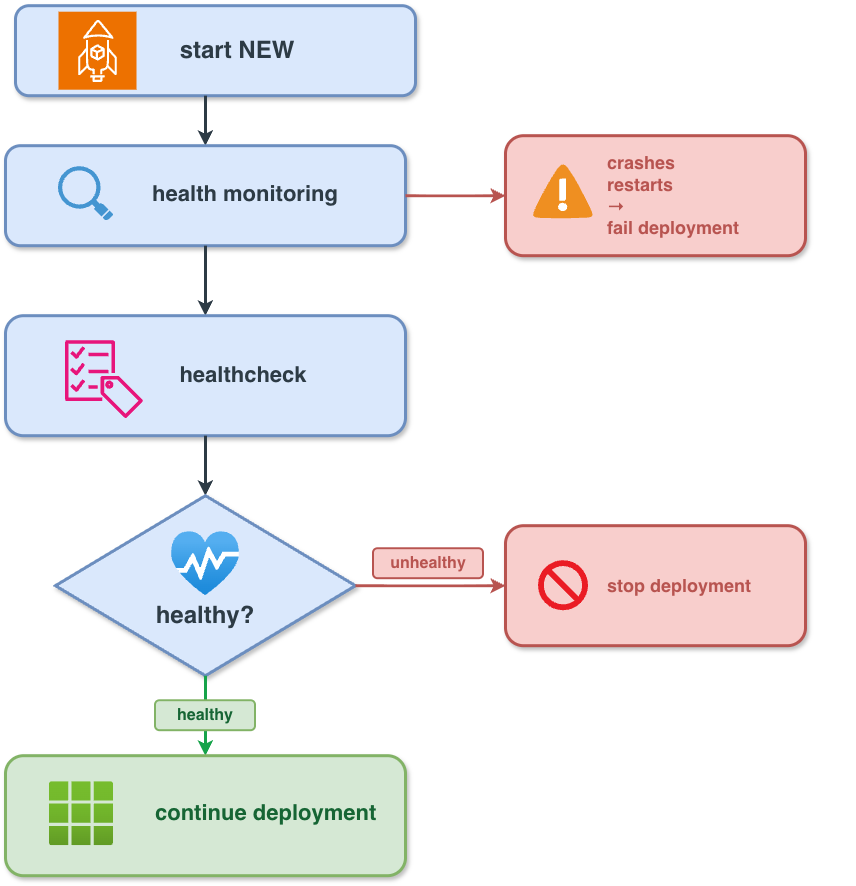
При rolling deployment Uncloud использует два связанных, но разных механизма: собственный health monitoring и стандартный Docker healthcheck.
После запуска нового контейнера Uncloud по умолчанию наблюдает за ним в течение 5 секунд, проверяя, что контейнер продолжает работать и не уходит в постоянный цикл перезапусков. Период можно изменить для конкретного сервиса через директиву deploy.update_config.monitor:
services:
  api:
    image: myapp:v2.0
    deploy:
      update_config:
        monitor: 30s
Значение 0s для monitor отключает monitoring. При этом monitor: 30s не обязательно означает, что Uncloud будет ждать ровно 30 секунд: если задан Docker healthcheck и контейнер становится healthy раньше, deployment может продолжиться досрочно.
Сам monitor не является полноценной проверкой готовности приложения. Прежде всего, он помогает понять, не падает ли новый контейнер сразу после запуска.
Если приложению требуется более надежная проверка, то ее можно определить с помощью healthcheck:
services:
  api:
    image: myapp:v2.0
    healthcheck:
      test: ["CMD-SHELL", "curl -f http://localhost:8000/health || exit 1"]
      interval: 5s
      timeout: 2s
      retries: 3
      start_period: 10s
Такой healthcheck уже может проверять реальную готовность приложения — наличие HTTP endpoint, доступность необходимых зависимостей или завершение инициализации.
Uncloud учитывает состояние Docker healthcheck во время и после monitoring period. Если контейнер становится healthy раньше окончания monitoring period, rollout может перейти к следующему контейнеру. Если после окончания monitoring контейнер остаётся unhealthy, Uncloud считает deployment неуспешным, останавливает новый контейнер и оставляет работать старый.
В итоге механизмы monitor и healthcheck вступают в действие на разных этапах работы:
Когда уже работающий контейнер внезапно становится unhealthy, Uncloud исключает его из Caddy upstreams. То есть healthcheck не является механизмом автоматического перезапуска контейнера.
Итак, мы можем запускать и обновлять контейнеры на разных машинах, но перед запуском образ должен оказаться на нужном Docker-хосте. Обычно для этого используется container registry. Для большой инсталляции это ок, но при небольшом self-hosted кластере из нескольких машин отдельный registry может оказаться ещё одной инфраструктурной сущностью, которую нужно разворачивать и обслуживать.
Uncloud решает эту задачу с помощью Unregistry - отдельного проекта автора Uncloud. Он реализует Docker Registry HTTP API и использует непосредственно локальное хранилище образов containerd на целевой машине.
Представим, что на локальной машине уже собран образ myapp:1.2.3
Вместо: docker push registry.example.com/myapp:1.2.3
и последующего docker pull на каждом сервере можно передать образ непосредственно на целевую машину.
Для самостоятельной работы Unregistry предоставляет docker pussh. В самом Uncloud тот же механизм используется через uc image push.
Например:
docker pussh myapp:1.2.3 user@server-01Что происходит под капотом?
Сначала docker pussh устанавливает SSH-соединение с удалённой машиной, на сервере запускается временный контейнер Unregistry. Через SSH-туннель пробрасывается случайный localhost-порт к порту этого контейнера, и локальный Docker CLI выполняет обычный docker push во временно запущенный registry. Затем контейнер Unregistry останавливается, а SSH-туннель закрывается — никакого постоянно работающего registry на каждом сервере не требуется.
При push Docker не передаёт образ целиком одним архивом. Образ состоит из manifest/config и набора content-addressed layers. Registry сначала сообщает клиенту о существующих слоях, а ему остается передать только отсутствующие.
Unregistry использует стандартный механизм Docker Distribution, поэтому при передаче образа на сервер уже существующие layers повторно не копируются. Именно это позволяет использовать его как своеобразный rsync для контейнерных образов.
Но внутри это полноценный registry endpoint, понимающий стандартный Docker Registry API. Отличие только в том, где он работает и где лежат данные.
Таким образом, Unregistry решает более узкую задачу — как эффективно доставить уже собранный image туда, где он будет запущен.
Именно поэтому для небольшого self-hosted окружения он выглядит привлекательно: вместо отдельного постоянно работающего registry можно использовать обычный SSH-доступ к машинам и передавать только недостающие слои образов.
Если в Compose используется директива build, Uncloud собирает образ с помощью Docker, а затем передает необходимые данные на целевые узлы через механизм Unregistry.
Для управления размещением сервисов по узлам в Uncloud есть расширение x-machines. Оно позволяет ограничить набор машин для конкретного сервиса.
Например:
services:
web:
image: myapp:1.0
scale: 3
x-machines:
- machine-1
- machine-2
В результате три реплики web распределяются только между machine-1 и machine-2.
Для базы можно сделать ещё жёстче:
db:
image: postgres:18
x-machines: machine-db
volumes:
- db-data:/var/lib/postgresql/data
Теперь тома и контейнер базы создаются на конкретной машине. При этом стандартная директива deploy.placement из Compose напрямую не поддерживается.
Хотя директива x-machines задает допустимые машины для размещения, Uncloud не превращает этот механизм в автоматический failover. Если машина становится недоступна, контейнеры, которые находились на ней, автоматически не переносятся на другую машину. Поэтому наличие нескольких реплик само по себе не означает автоматическое восстановление после отказа узла.
Uncloud плохо подходит для продуктивного размещения stateful приложений. Сервис умеет работать с Docker volumes и распределять контейнеры по узлам ( поэтому те же PostgreSQL, Redis и другие stateful контейнеры запускать можно), но диски с данными сами по себе не становятся автоматически распределёнными или реплицированными только потому, что контейнер находится в кластере. Поэтому вопрос восстановления кластеров СУБД при отказе узла требует отдельной проработки, необходимо самостоятельно позаботиться о механизмах репликации, кластеризации, резервного копирования и восстановления.
Важно не путать оркестрацию контейнеров с отказоустойчивостью приложения!
Можно иметь три сервера, десять реплик, WireGuard сеть и бесшовное обновление и всё равно получить downtime из-за отказа базы данных или одного локального диска.
Управление чувствительными даннымиДля production-приложений часто нужны пароли, API-токены, ключи и другие чувствительные данные. Хранить их в compose.yaml или .env неудобно и небезопасно.
Uncloud предоставляет механизм, позволяющий получать значение секрета непосредственно во время deployment. При этом сам Uncloud не является отдельным менеджером секретов и не требует собственного хранилища секретов. Вместо этого используется расширение x-command: Uncloud выполняет указанную локальную команду, а результат её выполнения использует как значение секрета.
Например:
services:
  api:
    image: myapp:latest
    environment:
      DB_PASSWORD: secret://db_password

secrets:
  db_password:
    x-command: op read "op://prod/myapp/db_password"
Здесь в compose.yaml не хранится сам пароль. Во время uc deploy Uncloud выполняет:
op read "op://prod/myapp/db_password"Значение, возвращаемое командой, подставляет вместо secret://db_password.
В примере используется официальный CLI 1Password - op. Перед запуском deployment он должен быть настроен и аутентифицирован в окружении, где выполняется uc deploy. Сам Uncloud при этом не получает и не хранит credentials 1Password (он просто запускает команду op read ... и получает результат).
Точно так же можно использовать HashiCorp Vault, AWS Secrets Manager или другой внешний источник, если для него существует CLI, доступный в окружении deployment.
Например, для Vault можно использовать:
secrets:
  db_password:
    x-command: vault kv get -field=password secret/prod/myapp
В этом случае аутентификацией в Vault занимается vault CLI, а не Uncloud.
То есть сам по себе Uncloud не содержит встроенных интеграций. Вместо этого используется общий механизм получения данных из вывода команды, запускаемой на узле. Это делает механизм достаточно универсальным: источник секрета может быть практически любым, если для него в окружении существует подходящий CLI или скрипт.
Здесь есть важное отличие от Kubernetes Secrets и Docker Swarm Secrets. Uncloud не создает распределенное хранилище секретов внутри кластера. Его задача - получить значение из внешнего источника в момент deployment и передать его приложению.
Кроме того, поддержка стандартного Compose secrets в Uncloud пока ограничена. В частности, текущая реализация рассчитана на использование секретов для подстановки значений в environment, в то время как модель с монтированием секрета в контейнер как файла /run/secrets/<name> не поддерживается.
При этом безопасность всей схемы по-прежнему зависит от среды, в которой выполняется uc deploy: пользователь или CI runner должен иметь необходимые права на получение секретов, а credentials к внешнему secrets manager должны защищаться и регулярно ротироваться.
Для продуктива важна наблюдаемость не только самого приложения, но и платформы, на которой оно работает. В Uncloud для этого есть несколько уровней диагностики: состояние узлов, самого Uncloud, кластерной сети и метрики, которые можно передать в стандартный monitoring stack.
Состояние хостовКоманда: uc machine ls показывает не только состояние узлов, но и важную информацию для эксплуатации кластера: IP-адреса, WireGuard endpoints, операционную систему, kernel, архитектуру, версию Docker и версию uncloudd.
В результате одним вызовом можно, например, обнаружить, что одна машина уже работает с другой версией Docker или daemon:
NAME        STATE   ADDRESS       DOCKER   VERSION
server-01   Up      10.210.0.1  	  29.4.0   0.20.0
server-02   Up      10.210.1.1   	 26.0.0   0.20.0
server-03   Up      10.210.2.1   	 29.5.3   0.20.0
Для автоматизации вывод можно получить в JSON-формате: uc machine ls -o json
Это уже позволяет использовать информацию о кластере в собственных скриптах и проверках.
Диагностика кластераИногда проблема находится не в приложении, а непосредственно в инфраструктуре Uncloud.
Для просмотра системных логов удалённых машин используется команда:
uc machine logs -f uncloud
Она позволяет получать journald-логи сервисов инфраструктуры сразу с удаленных узлов, не подключаясь по SSH к каждому серверу вручную.
Можно получать логи не только самого uncloud, но также Corrosion и Docker:
uc machine logs -f corrosion
uc machine logs -f docker
Это особенно удобно при разборе проблем, связанных с распределенным кластерным состоянием, запуском контейнеров или самим демоном Docker. Возможность потокового получения таких логов появилась с версии v0.19.0.
Поскольку сеть Uncloud построена поверх WireGuard и peer-to-peer взаимодействия, полезно видеть не только факт доступности машин, но и качество связи между ними.
Для этого существует: uc machine rtt
Команда показывает round-trip time между парами узлов кластера, включая медиану и среднеквадратическое отклонение. Эти данные собираются в процессе работы gossip-механизма Corrosion.
Например:
MACHINE     PEER        MEDIAN   STDDEV
server-01   server-02   140ms    ±19.4ms
server-01   server-03    39ms    ±1.1ms
server-02   server-03   203ms    ±42.3ms
Высокий RTT или его сильный разброс может быть причиной проблем с межузловым взаимодействием, особенно если нагрузка распределена между удаленными узлами.
Метрики PrometheusВ v0.20.0 каждый uncloudd также предоставляет эндпойнт для метрик Prometheus, слушающий на порту 51090 по пути /metrics.
http://<machine-ip>:51090/metricsEndpoint слушает на внутреннем IP хоста, и его можно подключить непосредственно к существующей системе мониторинга.
Наблюдаемость сервисовНа уровне приложений остаются привычные Docker-подобные команды:
uc ps
uc logs backend
uc logs backend/2f60
uc logs работает на уровне сервиса и может собирать логи контейнеров с разных машин. С версии v0.19.0 появилась возможность фильтрации логов по конкретному контейнеру. При необходимости можно обратиться к одной реплике сервиса, что особенно удобно, когда один контейнер ведёт себя неправильно, а остальные работают нормально.
Это не заменяет полноценный observability stack для приложения, так как метрики бизнес-логики, трейсы, логи приложений и отслеживание состояния СУБД всё ещё остаются отдельной задачей. Но для самой платформы Uncloud уже предоставляет базовый набор инструментов, достаточный для понимания состояния узлов, сервисов, сети и контейнеров.
Свой среди чужихUncloud — не единственный проект, который пытается решить задачу «несколько Docker-хостов, но без полноценного Kubernetes». Есть ещё несколько похожих инструментов с иными подходами и поэтому их нельзя считать прямыми взаимозаменяемыми аналогами.
Swarm ближе всего к классическому оркестратору: он превращает несколько Docker-хостов в кластер и сам управляет размещением и жизненным циклом сервисов.
Kamal находится ближе к deployment-инструментам. Он позволяет раскатывать Docker-приложения на обычные сервера, но не пытается превращать их в единый кластер с собственной сетевой и service discovery моделью.
Nomad идёт ещё дальше от Docker Compose: это по сути отдельный планировщик общего назначения со своей моделью нагрузки. Docker - лишь один из поддерживаемых типов задач.
Uncloud делает ставку именно на существующий Docker workflow. Его задача - добавить к нескольким Docker-хостам общую сеть, service discovery, ingress, image distribution и deployment, не заставляя пользователя переходить на отдельную модель ресурсов и конфигурации.
Разница между этими проектами лучше всего определяется не количеством поддерживаемых функций, а тем, какую абстракцию каждый из них предлагает поверх обычных серверов.
Для Swarm это Docker cluster, для Nomad - scheduler, для Kamal - deployment layer, а для Uncloud - попытка сделать из нескольких Docker-хостов одну среду, сохранив максимально знакомый Compose-oriented workflow.
Сравним наглядно:
Инструмент | Основная идея | Архитектура | |||
Docker Swarm | Классический orchestration для Docker | Кластер с manager nodes, scheduling и встроенной service model | |||
Kamal | Простой deployment на обычные серверы | Docker + SSH + deployment automation | |||
Nomad | Лёгкий универсальный scheduler | Отдельная модель jobs/allocations и полноценное распределение workloads | |||
Uncloud | Multi-host Docker с сохранением Compose подхода | Docker + распределенное состояние + WireGuard + собственный service discovery | |||
Uncloud выглядит наиболее органично в небольшой или средней self-hosted инфраструктуре: несколько VM или bare-metal серверов, десятки контейнеров, уже существующий Docker Compose и потребность добавить multi-host networking, service discovery, ingress, scaling и rolling deployment.
Kubernetes тоже может решить эту задачу, но есть вопрос в цене самой платформы — control plane, модель ресурсов, экосистема и требования к ее эксплуатации могут оказаться избыточными для небольшой команды.
При этом Uncloud не пытается конкурировать с Kubernetes там, где нужны сложная multi-tenant инфраструктура, развитый RBAC или сложная политика scheduling. Иными словами, Uncloud имеет смысл рассматривать как следующий шаг после single-host Compose, когда одного Docker-хоста уже недостаточно, но полноценная Kubernetes-платформа ещё не решает реальную проблему лучше.
При этом приложение должно соответствовать ограничениям поддерживаемой Uncloud части Compose Specification, а для stateful workloads заранее необходимо определить модель хранения, резервного копирования и восстановления.
Чеклист для продуктиваПеред развертыванием системы рекомендуется:
1. Проверить совместимость Compose-файла с support matrix Uncloud.
2. Определить политики start-first и stop-first для каждого критичного сервиса.
3. Описать правильные healthcheck для приложений.
4. Определить размещение контейнеров для stateful workloads через x-machines и стратегию хранения персистентных данных.
5. Протестировать поведение при отказе контейнера, всего узла и потери сетевой связности.
6. Определить требуемые публичные ingress-порты.
7. Позаботиться о резервном копировании критичных данных.
ИтогUncloud не пытается стать маленьким Kubernetes. Его идея в другом — оставить привычный Compose workflow и добавить инфраструктурный слой для multi-host deployment, включающий в себя cluster state, сетевую топологию, механизм service discovery, ingress, управление образами и возможность бесшовного обновления.
Цена этой простоты — специфичная модель отказа, ограниченная совместимость с Compose и отсутствие автоматического перераспределения рабочей нагрузки при потере узла. Поэтому Uncloud стоит оценивать не как замену Kubernetes, а как инструмент для конкретного класса self-hosted задач.
Это не Kubernetes, который ещё не успел вырасти. Это попытка вообще не становиться Kubernetes.
Источники и документация:| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1 | 0 | 10.42 | 16-10-2026 |
| 2 | Когда Docker Compose уже мало, а Kubernetes еще слишком много: знакомство с Uncloud. Часть 1 | 0 | 10.42 | 16-10-2026 |
| 3 | Книга: «Kubernetes. Полное руководство по развертыванию и управлению Kubernetes в облачных и локальных средах. 2-е изд.» | 0 | 7.77 | 21-05-2026 |
| 4 | Docker Fundamentals: что внутри compose.yaml и как там всё устроено | 0 | 8.14 | 24-07-2026 |
| 5 | Многоэтапные сборки в Docker: как уменьшить образ с 1,2 ГБ до 50 МБ | 5 | 8 | 28-06-2026 |
| 6 | Отказоустойчивость в мультиклауде: архитектура и реальные кейсы | 0 | 10.42 | 17-09-2026 |
| 7 | Памятник kubelet, Kubernetes != CRI | 0 | 7 | 13-07-2026 |
| 8 | Инверсия приоритетов в Kubernetes: Когда планировщик убивает бизнес, спасая «важные» поды | 0 | 7 | 13-07-2026 |
| 9 | Тимлид и subnet-полукровка: как одна строчка в YAML стоила $50 000 и двенадцати часов прода | 0 | 8.44 | 10-08-2026 |