Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASADas offene Modell soll Prognosen aus Tabellen liefern, ohne dass Anwender es erst anlernen oder einstellen müssen. Die Gewichte sind frei verfügbar und dürfen auch kommerziell genutzt werden.
Anbieter zum Thema
Das offene Modell soll Prognosen aus Tabellen liefern, ohne dass Anwender es erst anlernen oder einstellen müssen. Die Gewichte sind frei verfügbar und dürfen auch kommerziell genutzt werden.
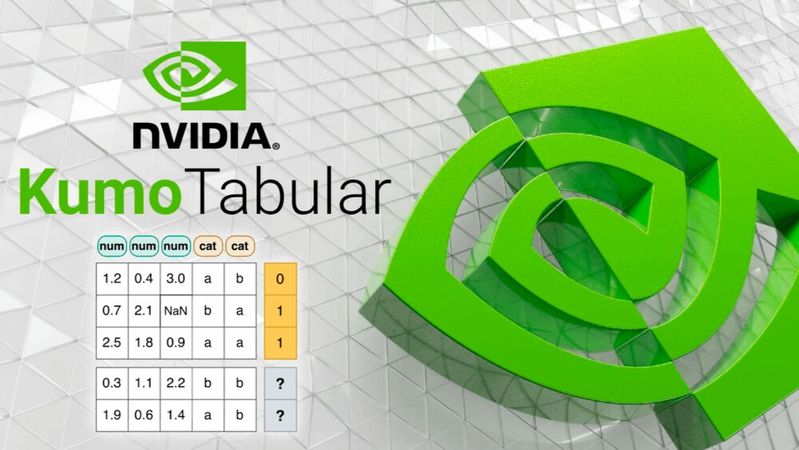 Kumo Tabular bekommt eine Tabelle mit bekannten Ergebnissen und soll für die Zeilen mit Fragezeichen den Wert voraussagen, ohne vorher darauf trainiert zu werden.
(Bild: Nvidia)
Nvidia hat mit Kumo Tabular ein offenes Foundation-Modell für Tabellendaten veröffentlicht, das Klassifikations- und Regressionsaufgaben ohne Training und Feature Engineering lösen soll.
Das Prinzip kennt man von Sprachmodellen: Anwender geben dem Modell eine Tabelle mit bekannten Ergebnissen und dazu die Zeilen, für die sie eine Vorhersage brauchen. Kumo Tabular soll daraus in einem Durchgang Wahrscheinlichkeiten für Kategorien oder konkrete Zahlenwerte berechnen. Bei Zahlenwerten gibt es auch eine Einschätzung, wie sicher die Prognose sei.
Das Modell gibt es in drei Größen mit 28 bis 215 Millionen Parametern. Trainiert wurde es nach eigenen Angaben nicht mit echten Firmendaten, sondern ausschließlich mit künstlich erzeugten Tabellen. Je nach Größe sah es 35 bis 137 Millionen davon. Die Architektur baue auf den Vorarbeiten TabICL und TabPFN auf.
Einschränkungen gibt es wohl auch: Das Modell verstehe nur Zahlen und Kategorien. Text und Zeitstempel müssten vorher umgewandelt werden. Pro Durchgang könne es bis zu zehn Klassen unterscheiden, bei mehr Klassen helfe ein Zusatzverfahren der Bibliothek. Trainiert wurde mit Tabellen von bis zu 60.000 Zeilen und 100 Spalten. Bei deutlich größeren Tabellen oder stark abweichenden Daten könne die Trefferquote sinken. Nvidia rät deshalb, das Modell vor dem Einsatz mit eigenen Daten zu testen.
Die Gewichte liegen auf Hugging Face, der Code auf GitHub. Die Lizenz OpenMDW-1.1 erlaube auch den kommerziellen Einsatz. Trainingsrezept und Datengeneratoren will Nvidia später nachreichen.
Bisher setzen Unternehmen für solche Prognosen meist Gradient-Boosted Trees ein, also Entscheidungsbaum-Verfahren, die für jede neue Aufgabe eigens trainiert werden. Der Ansatz, Tabellenmodelle mit künstlichen Daten vorzutrainieren, wurde zuletzt durch TabPFN bekannt.
(ID:50972714)
| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Nemotron 3.5 Lightning: Nvidias offenes 30B-MoE-Modell für KI-Agenten | 0 | 20.73 | 12-08-2026 |
| 2 | Offener Brief: Microsoft, Nvidia & Co. fordern offenes KI-Ökosystem | 0 | 20.34 | 25-07-2026 |
| 3 | NVIDIA открыла веса Cosmos 3 Edge — компактной модели мира для роботов и автономных систем | 0 | 15.15 | 22-07-2026 |
| 4 | Nvidia launches new open-source AI security alliance | 0 | 9.61 | 27-07-2026 |
| 5 | Nvidia’s version of OpenClaw could solve its biggest problem: security | 0 | 8.57 | 16-03-2026 |
| 6 | China’s Kimi K3 and the rise of open-weight AI models | 0 | 11.07 | 23-07-2026 |
| 7 | NVIDIA ПРЕДСТАВИЛА COSMOS 3 EDGE: ОТКРЫТАЯ МОДЕЛЬ МИРА ДЛЯ ЛОКАЛЬНОГО ... | 0 | 7 | 21-07-2026 |
| 8 | ℹ [club62032126|NVIDIA АВТОМАТИЗИРОВАЛА ДООБУЧЕНИЕ COSMOS 3 С ПОМОЩЬЮ ИИ-АГЕНТА] В ... | 5 | 7 | 16-07-2026 |
| 9 | Databricks kauft Row Zero für Genie-Tabellen | 0 | 13.41 | 08-10-2026 |
| 10 | Meta Releases Muse Glimmer, a 30-Billion-Parameter Open-Weight AI Model That Runs on a Single Consumer GPU | 0 | 5.06 | 11-08-2026 |